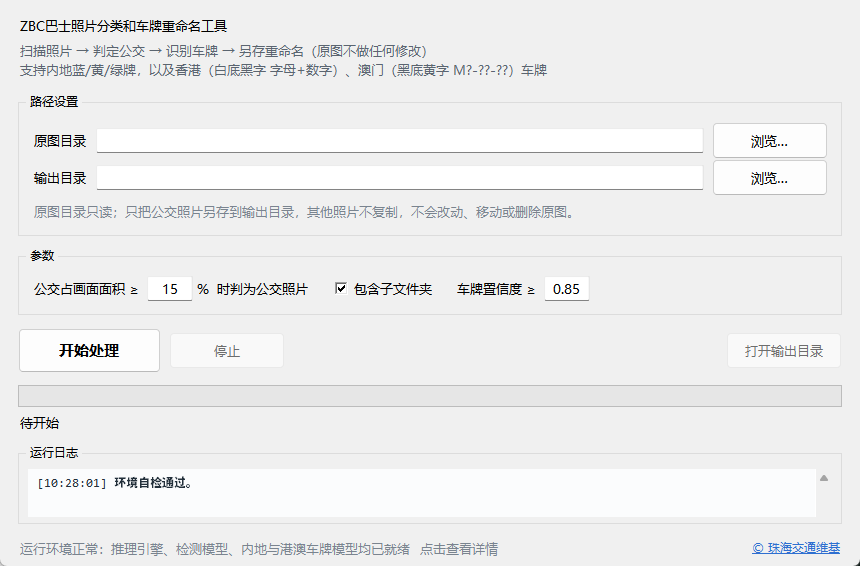
图库批量分拣
按「巴士是否占据画面主体」逐张判定,只把巴士照片挑出来,其余原样留在原处。
- 可递归扫描子文件夹,一次处理上千张
- 占画面比例阈值可调(默认 15%)
- 支持随时中止,已完成的部分照常保留
核心能力
不是又一个需要折腾的脚本工具。它只做巴士照片整理这件事,但把这件事做完整。
按「巴士是否占据画面主体」逐张判定,只把巴士照片挑出来,其余原样留在原处。
内地、香港、澳门三套车牌规则各自独立,先看底色再读字符,不会把澳门牌硬套成内地格式。
源目录以只读方式打开,不移动、不删除、不改名。所有产物都写到你自己指定的输出目录。
车牌支持
车牌识别最容易出错的地方不是读字,而是「用错规则」。程序先判断车牌底色与区域,再套用对应编码校验, 不合法的结果宁可不命名,也不会硬凑一个出来。
蓝牌 · 黄牌 · 新能源绿牌
白底黑字,1~2 个字母 + 1~4 位数字
黑底黄字 / 黑底白字,M+字母+两段数字
分两行印刷的花牌会自动合并为 MH-94-83
使用流程
没有命令行、没有配置文件、不需要装 Python。整个流程就是四个动作。
指定「原图目录」(只读)与「输出目录」。可勾选是否包含子文件夹。
分割模型算出巴士占画面比例,达到阈值即判为巴士照片,低于阈值归入其他照片。
定位车牌框、判断底色、读字符并校验编码。同框有多辆车时,取离镜头最近的那一块车牌。
复制到「公交照片」并命名为 车牌_序号.jpg;不确定的放进「_待复核」。
输出结果
处理完不只是一个堆满文件的文件夹。每张照片的判定依据都写在报表里, 哪张命名错了、哪张为什么进复核,都能回头查。
实拍样本
以下结果全部来自 6000×4000 的原图实拍样本,逐张放大裁图核对。 「命名正确」指车牌号完全读对;读不准的一律进入待复核,不会被强行命名成错误结果。
* 澳门样本多为车尾视角,车牌仅有 40×20 像素或被车身广告遮挡,这类困难样本会进入待复核目录, 由人工确认后自行改名。香港样本覆盖 10 个不同车牌,澳门样本覆盖 15 个。
运行环境
常见问题
不会。程序只以读取方式打开源目录里的照片,所有写入都发生在你指定的输出目录里。 不移动、不删除、不改名,也不会回写任何 EXIF 或时间戳。中途停止或出错,原图同样不受影响。
因为车牌太小、被遮挡、逆光或严重模糊,程序算不出一个可信的车牌号。
这种情况下它不会猜一个看起来像的结果填上去,而是把照片放进 _待复核,
并在 report.csv 里写明原因。人工确认后再改名,比事后从一堆错名字里找出来省事得多。
因为澳门车牌本身就是这样印刷的。程序按 M?-??-?? 的原始格式输出,
例如 MK-79-28,便于和车牌实物逐字对应。分两行印刷的车牌(上行 MH、
下行 94-83)会自动合并成同一个号码。
当前验证的是白底黑字前牌,格式为 1~2 个字母加 1~4 位数字(如 WA3855、XU8478),
已在 13 张城巴实拍照片上验证。黄底后牌与纯数字老牌暂时没有足够的实拍样本,
遇到读不准的会进入待复核,不会误命名。
6000×4000 的原图约 2~3 秒一张(含模型推理),具体取决于 CPU 核心数与磁盘读写速度。 清晰的车牌会走快速路径,不必额外的图像增强,因此比模糊样本更快。
优先取画面主体(检测框最大)的那辆车上的车牌;如果两辆车的车牌都落在判定范围内, 按车牌在画面中的像素高度取「更近」的那一块 —— 近大远小,主车通常离镜头更近。 程序宁可判定为歧义放进待复核,也不会在两块车牌之间随机选一个。
默认阈值是「巴士占画面面积 ≥ 15%」。整条街的远景里巴士只占几个百分点,会被归为其他照片。 遇到这类素材,把界面上的阈值调到 5%~8% 即可,程序会重新按新阈值判定。
下载
解压后双击 exe 即可运行,不需要安装 Python,也不依赖任何运行库。
SHA-256 16aeaf1621da9c376b532f4335683d3e1666cf6cc11c15603b0e55b14bba69bc
手机扫码打开本页